Ugrás a tartalomra

AI hírek, hogy ne maradj le

2026. október 28., szerda · frissítve 22:52
Vissza a hírekhez
Hugging Face (LinkedIn)2026. okt. 9. 15:29eszköz

7-szer hosszabb szöveggel is taníthatók AI-modellek az új TRL-lel

A Hugging Face kiadta a TRL v1.15-ös verzióját, amely jelentősen csökkenti a memóriahasználatot, így sokkal hosszabb kontextussal finomíthatók a modellek.
0
TRL v1.15 is out, and it’s an absolute banger of a release for memory-efficient post-training.

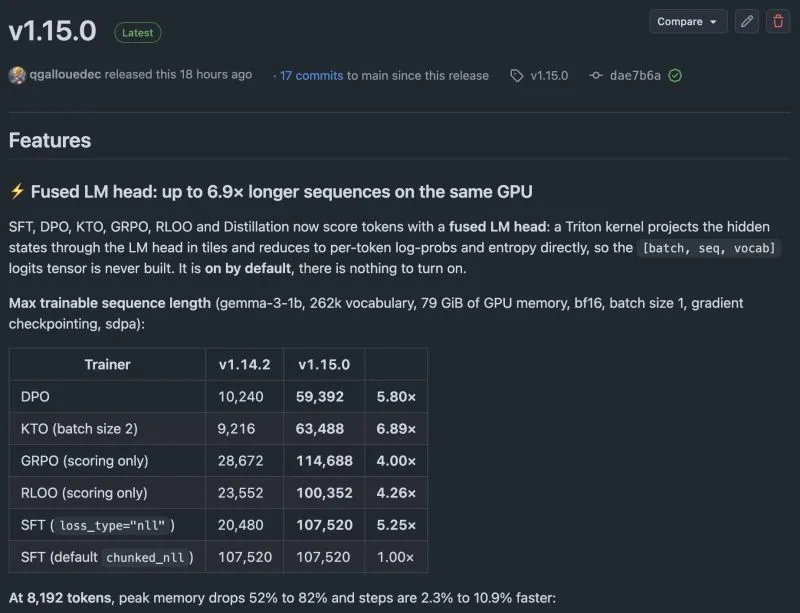
A Hugging Face megjelentette a TRL v1.15-ös frissítését, amely komoly hatékonyságnövekedést hoz a nyelvi modellek utólagos betanításában. Az új verzió alapértelmezetten egy összevont nyelvi modellfejet használ, amely közvetlenül számítja ki a szükséges értékeket ahelyett, hogy hatalmas adatmennyiséget generálna a memóriában.

A változtatásnak köszönhetően a modellek akár 6,9-szer hosszabb szövegkörnyezetet képesek kezelni ugyanazon a hardveren, miközben a memóriahasználat 52 és 82 százalék között csökkent. A tesztek alapján a betanítási sebesség is javult, a folyamat nagyjából 11 százalékkal lett gyorsabb.

A frissítés emellett hatékonyabb memóriakezelést biztosít a képi adatsorokhoz, javítja a beszélgetések naplózását, és számos hibajavítást is tartalmaz. A fejlesztők számára jó hír, hogy a betanítási folyamat kódja nem bonyolódott, a háttérben futó optimalizáció automatikusan működik.

Az eredeti szöveg (Hugging Face (LinkedIn))
TRL v1.15 is out, and it’s an absolute banger of a release for memory-efficient post-training. The main change: SFT, DPO, KTO, GRPO, RLOO and Distillation now use a fused LM head by default.Instead of materializing the huge [batch, seq, vocab] logits tensor, a Triton kernel computes the token-level quantities we actually need directly. The results are quite significant. On Gemma 3-1B with a 262k vocabulary, on the same GPU: DPO: 10k → 59k max sequence length KTO: 9k → 63k GRPO: 28k → 114k RLOO: 23k → 100k SFT: 20k → 107k Up to 6.9x longer sequences, with peak memory at 8k context reduced by 52-82%. Speed isn't negatively impacted: training is also up to ~11% faster. There’s more in the release too: selective activation checkpointing for SFT, assistant-only loss for vision datasets, better conversation logging, improvements to AsyncGRPO / AsyncDistillation, and a long list of fixes. I really like optimizations like this: the training API doesn’t need to become more complicated as the implementation underneath gets much better.

Az oldal magától nem használ sütit. A hozzájárulásoddal a látogatottságot a Google Analytics, a Facebook-hirdetéseink eredményét a Meta pixel méri. Részletek